新手学习与入门 · 工具介绍
docTR
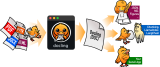
docTR 通过文本检测与字符识别两阶段处理文档,可从 PDF 和图像定位并识别文字,返回页面、文本块、行和词的层级结构,并支持可视化和字典导出。
docTR 能做什么
docTR 通过文本检测与字符识别两阶段处理文档,可从 PDF 和图像定位并识别文字,返回页面、文本块、行和词的层级结构,并支持可视化和字典导出。
- 文档解析与格式转换
如何使用 docTR
识别 PDF 中的文字并检查结构化结果
准备输入
- 待识别的 PDF 文档及已安装的 docTR 模型环境。
操作步骤
- 创建 ocr_predictor,并通过 DocumentFile.from_pdf 读取文档。
- 调用模型处理文档,使用 result.show 查看识别与定位结果。
- 通过 result.export 导出嵌套字典,逐页核查文字及结构。
预期交付物
- 包含页面、块、行和词等层级的识别结果及可用于 JSON 的嵌套字典。
旋转页面与不同文字方向需要匹配相应框设置;人工核对数字、专名和阅读顺序,不把 OCR 输出当作已校对文本。
开始前需要了解
账号权限、费用与可用功能请以官方入口的当前说明为准。重要结果应先检查,再用于实际工作。
从新手学习与入门角度评估docTR
把新手学习与入门需要的条件列清楚,再比较工具。阅读本页的产品用途、步骤与限制,再逐项确认下面的问题;这些是选型方法,不表示每款工具都具备同样能力。
从熟悉任务开始
选择你能判断结果好坏的小任务,便于发现偏差。
输入是否容易准备
文字粘贴即可开始时,不必先学习复杂的连接与部署。
结果是否能检查
要求清晰格式,保留不确定内容和需要你确认的问题。
选择一个小样任务,先检查结果与交付格式,再决定是否用于更多资料。